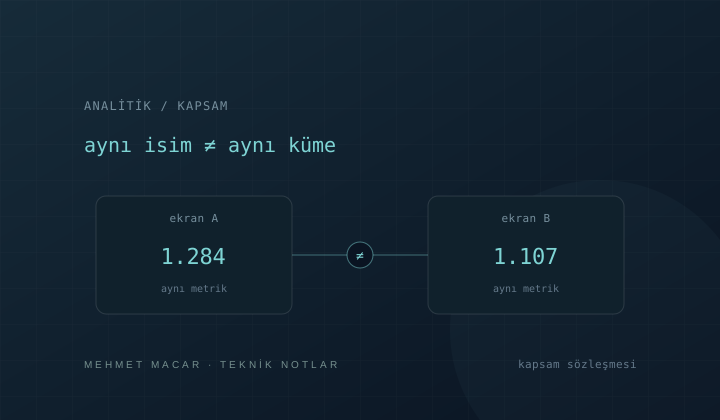
İki ekranda aynı isimli metrik farklı göründüğünde hemen sorguyu değiştirmek cazip. Oysa önce iki ekranın gerçekten aynı soruyu cevaplayıp cevaplamadığını anlamak gerekir. AI burada hızlı bir kod üreticisinden çok, gözden kaçan varsayımları görünür kılan bir yardımcı olabilir.
Bu yazıdaki örnekler temsili. Herhangi bir kurumun kayıtları, metrikleri veya iç raporları kullanılmıyor.
Soruyu ölçülebilir hâle getir
"Sayılar neden farklı?" sorusunda veri kümesi bile belli değildir. İncelemeye başlamadan şu dört bilgiyi yaz: metriğin adı, iki ekrandaki değer, seçili dönem ve her ekranın kullandığı filtreler. Ardından beklediğin davranışı bir cümleyle anlat. Örneğin: "Aynı tarih aralığı ve aynı filtreler seçildiğinde tamamlanan kayıt sayısı eşit olmalı."
AI'a ilk turda çözüm değil, eksik tanımları sordururum:
İki raporda aynı adlı metrik farklı çıkıyor. Kayıtların içeriğini paylaşmıyorum. Olası ayrışmaları veri kümesi, tarih alanı, durum tanımı ve filtreler altında grupla. Her olasılık için hangi bilgiyi kontrol etmem gerektiğini yaz. Henüz kod önerme; bilmediğin alanları varsayım olarak işaretle.
Bu istemin değeri, cevabın tek bir nedene kilitlenmesini önlemesidir. "Yanlış sorgu" yalnızca ihtimallerden biridir.
Hipotezleri küçük testlere çevir
AI'ın verdiği olasılık listesini gerçek kayıtlar üzerinde sırayla sınamak gerekir. İlk iş, iki ekranda ortak görünen kayıtları ve yalnızca birinde görünenleri ayırmaktır. Farkın tümü dönem sınırında mı? Belirli bir durumda mı? Bir filtre yalnızca bir ekranda mı uygulanıyor?
Burada AI'a ikinci bir görev verilebilir:
Elimde gerçek verilerden türetilmemiş, tamamen temsili iki küçük kayıt listesi var. Hangi kayıtların yalnızca bir listede kaldığını bulmam için bir karşılaştırma planı hazırla. Her bulguyu bir hipoteze bağla. Veriden çıkmayan bir nedeni kesin sonuç gibi sunma.
Gerçek kişi, kurum veya iş bilgilerini modele aktarmadan da yöntem tartışılabilir. Sentetik birkaç satır, genel alan adları ve beklenen sonuç çoğu zaman yeterlidir.
AI cevabını nasıl doğrularım?
Bir açıklamanın makul görünmesi yeterli değil. Seçilen hipotez, farkı oluşturan kayıtları gerçekten açıklamalı. Aynı tanım iki ekrana uygulandığında sonuçlar eşleşmeli; farklı tarih aralıkları ve boş veri gibi sınır durumları da denenmeli. Son olarak metriğin adı, kullandığı kapsamı okura açıkça anlatmalı.
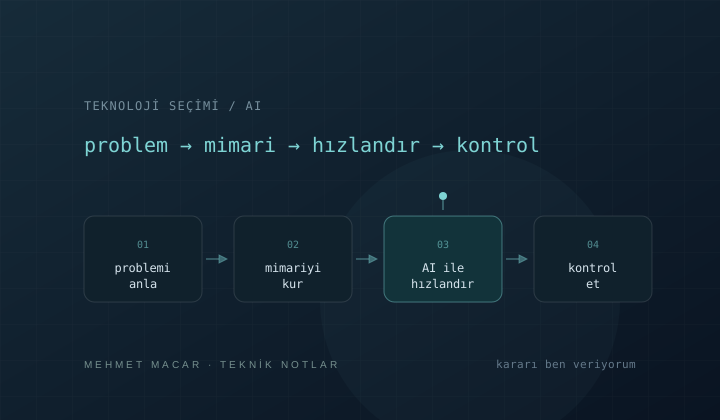
AI kod da önerebilir, ama karar sırası önemlidir: önce "neyi sayıyoruz" sorusunun cevabı, sonra bunu hesaplayan kod. Tanım belirsizken hızla üretilen sorgu, yalnızca belirsizliği otomatikleştirir.